
こんにちは、プロダクト基盤部バックエンドグループの jun です。普段はフレームワーク寄りの機能開発やパフォーマンスチューニング、大きめのリファクタリングや移行など、プロダクトの土台を支える仕事をしています。
今日は、私が最近よく使っている e2e 検証のやり方 —— AI エージェント(Claude Code)に実ブラウザで画面を操作させ、X-Request-Id ヘッダと Rails のログを使って、アクション単位に SQL やバリデーションまで観測する —— という手法を紹介します。特別なミドルウェアもツールも要らず、Rails が元々持っている仕組みに乗るだけで成立するのがポイントです。
「テストは全部グリーンなのに、実際にフロントから叩くと壊れる」。この手の事故を減らしたい人に届けば嬉しいです。
なぜ従来の e2e / request spec だけでは足りないのか
まず、私が困っていたことから。
1. request spec は「型」を作者が決めてしまう
request spec はとても便利ですが、in-process で Rack を直接叩くため、実 HTTP でしか起きないことを通り抜けてしまいます。
一番はまりやすいのが型とエンコードです。HTTP 自体は型を持ちません。クエリ文字列や form-encoded で送られた値は、コントローラに届く時点ですべて文字列です。ところが request spec では、どのエンコードで送るかを spec の作者が選べてしまいます。
post "/articles", params: { status: 2 }             # form-encoded → "2"(String)が届く
post "/articles", params: { status: 2 }, as: :json  # JSON → 2(Integer)のまま届く
実際のフロントエンドは form-encoded で status=2(文字列)を送っているのに、spec だけ as: :json の Integer で通している——そんなズレがあると、enum の型不一致(文字列 vs 整数)のような、本番でだけ火を噴くバグを spec がすり抜けます。ブラウザの CORS 挙動や Web サーバ層、開発/テスト環境の設定差も、request spec では現れません。
2. 「ログをテーブル名で勘 grep」はノイズだらけ
じゃあ開発サーバに実リクエストを飛ばしてログを見ればいい、と思いますよね。ところが development.log は、他タブのポーリング、ログイン処理、無関係な API のログが入り混じっていて、どの操作でどのクエリが出たのかを対応づけられません。テーブル名やコントローラ名で勘を頼りに grep する、という不毛な作業になりがちでした。
3. システム移行では「同じ操作を新旧2系統で叩きたい」
さらに、私はいまシステム移行に関わっていて、「旧実装と新実装にまったく同じ操作を叩いて、挙動差(parity)を見たい」という要求があります。これを手作業でやるのはかなり苦しい。
設計のアイデア:「実HTTPで動かして、ログで確かめる」を1対1に対応づける
ここで使うのが X-Request-Id です。リクエストごとに ID を採番してログ行に紐づける仕組みは、実は多くの Web フレームワークが標準で備えています。ここでは Rails を例に見てみましょう。
# config/environments/development.rb
config.log_level = :debug          # SQL 行をログに出す
config.log_tags  = [:request_id]   # 全ログ行の先頭に [request_id] が付く
そして ActionDispatch::RequestId ミドルウェアは、受信した X-Request-Id ヘッダの値を、そのリクエストの request_id としてそのまま採用します(値はサニタイズされます。後述)。
# ActionDispatch::RequestId(抜粋)
req.request_id = make_request_id(req.headers["X-Request-Id"])
# make_request_id → request_id.gsub(/[^\w\-@]/, "").first(255)
この2つを合わせると、次の等式が成り立ちます。
テスト対象の API にだけ好きな
X-Request-Idを付ける = そのアクションのログ行にだけ、その値がタグとして付く
たとえば記事作成のリクエストに X-Request-Id: e2e-article-create を付けておけば、そのリクエストが流したログ(Controller、SQL、バリデーションエラー)の先頭にだけ [e2e-article-create] が付きます。あとは grep '\[e2e-' で拾えば、そのアクションのログだけを他のリクエストに紛れずに追えます。やっていることは、本当にこれだけです。
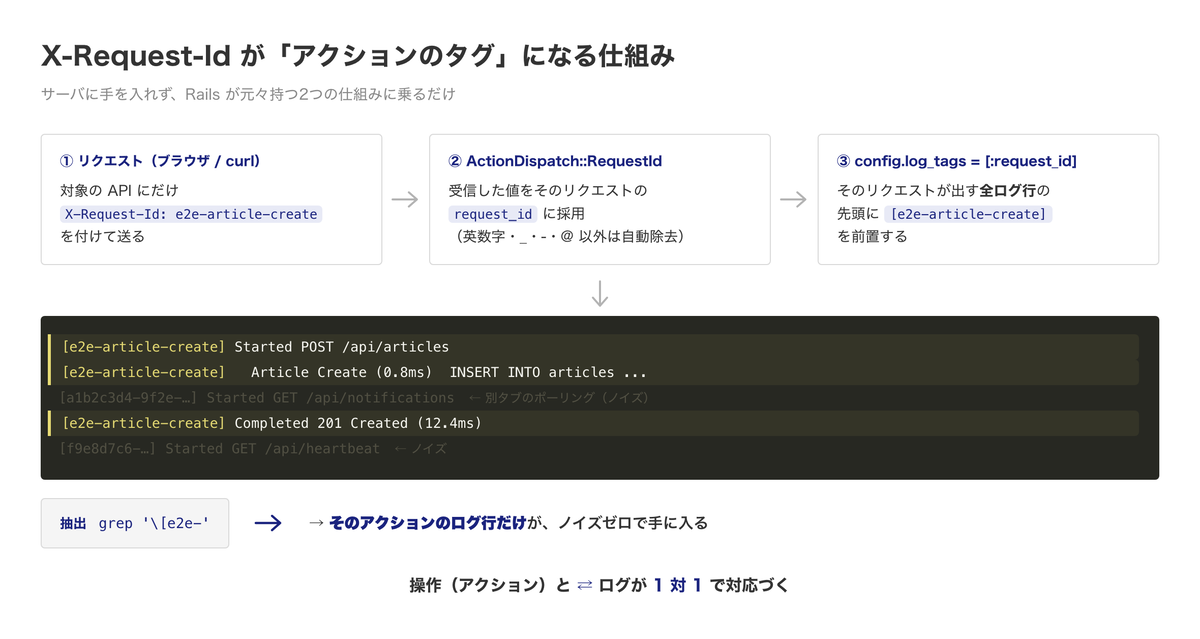
図1:サーバに手を入れず、Rails が元々持つ log_tags と ActionDispatch::RequestId に乗るだけで、アクションとログが 1 対 1 で対応づく。
X-Request-Id を選ぶのは、事実上の標準ヘッダとしてロードバランサやリバースプロキシがトレース用に付ける慣習があり、サーバ側に一切手を入れずに既存の仕組みへ乗れるからです。本来は分散トレース用のヘッダを、「アクション識別子」として転用しているわけですね。
どうタグを付けるか:2つの経路と、1つのガードレール
経路A(主役): UI 操作 + ネットワーク層でのヘッダ注入
主役は「AI エージェントが実ブラウザで画面を操作する」経路です。ここで、対象 API のパスにマッチしたリクエストにだけ、Playwright のネットワーク傍受でヘッダを注入します。
await page.context().route(/\/api\/(articles|comments)/, async route => {
  const headers = { ...route.request().headers(), 'x-request-id': `e2e-${currentTag}` };
  await route.continue({ headers });   // ← ここでタグを注入する。URL は変えない
});
currentTag を「一覧表示」「新規作成」「空で保存(バリデーション)」…とアクションごとに書き換えていけば、実際のボタン操作から飛ぶ XHR に、そのアクションのタグが付きます。
経路B: サーバサイドの curl
レスポンス本文そのものを比較したいとき(JSON のフィールド構造や日付フォーマットの差など)は、ブラウザの外から curl で叩きます。ブラウザ外なので CORS の制約がなく、ヘッダを自由に付けられます。
curl -s -H 'X-Request-Id: e2e-cmp' -H 'Cookie: <session>' http://localhost:3000/api/articles
なぜ fetch で直接付けないのか(CORS の話)
ちなみに、「ブラウザの fetch に自前で X-Request-Id を付ける」という手は、うまくいかないことが多いです。カスタムヘッダを付けたクロスオリジンの fetch は CORS の preflight(OPTIONS)を発火させ、それが通るかどうかはサーバの Access-Control-Allow-Headers 次第だからです。X-Request-Id を許可リストに入れていなければ弾かれ、本リクエストはサーバに届きません(そして、検証のためだけに本番の CORS 許可リストへテスト用ヘッダを足すのも避けたいところです)。
一方、経路A の route.continue({ headers }) は、アプリ自身が投げる(=すでに許可済みの)XHR にネットワーク層で後付けするだけなので、新たな preflight を発火させません。経路B の curl は、そもそもブラウザの外なので CORS とは無関係です。
つまり、UI 操作 + route 注入とサーバサイド curlは、どちらも自分のアプリの CORS 設定に依存せずに動きます。「その環境の CORS が X-Request-Id を許可しているか」を気にせず使えるので、この2つを基本の経路に据えるのがおすすめです。
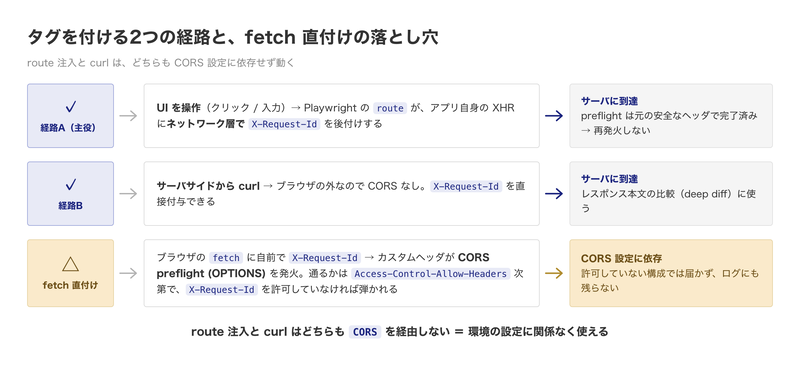
図2:fetch 直付けが通るかは CORS の許可設定(Access-Control-Allow-Headers)次第。route 注入と curl はどちらも CORS を経由しないので、設定に関係なく使える。
どう観測するか:Claude Code の Monitor
タグを付けたら、あとは拾うだけ。Claude Code の Monitor を使うと、ログの追記をバックグラウンドで監視し、条件に合った行が出るたびに通知してくれます。
Monitor({
  command: 'tail -f log/development.log | grep -E --line-buffered "\\[e2e-"',
  description: "e2e log (tagged)",
  persistent: true
})
grep のパターンは \[e2e- のたった1本で済みます。タグ付き行だけが [e2e-...] を持つので、他タブもポーリングもログインも構造的に入ってきません。細かいコツとしては、--line-buffered を付けないとパイプのバッファリングで通知が数分遅れること、リクエストを大量に投入するときは Started |Completed [45] のようにさらに絞ること、くらいです。
そして、これが AI エージェントと相性がいい。Monitor はイベントを非同期で通知してくるので、エージェントは「画面を操作する → Started POST がログに出るのを待つ → 出たら次の操作へ」というループを、実 HTTP の発火を確認しながら回せます。「タグを設定したから API は飛んだはず」と決めつけて先へ進むと取りこぼすので、ログに実際の発火が出たのを見てから次の操作に移る。地味ですが、この一手間があるとないとで検証の精度がかなり変わります。
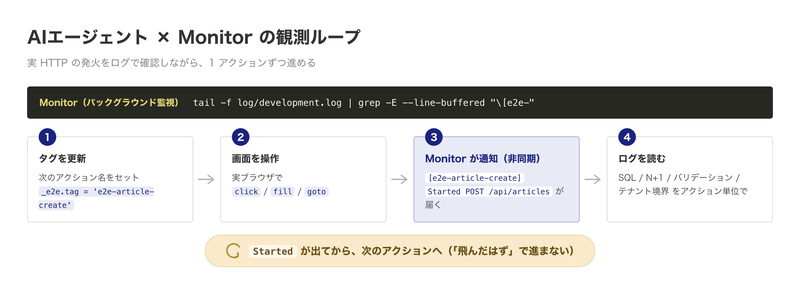
図3:タグ更新 → 画面操作 → Monitor の非同期通知 → ログを読む、を1アクションずつ回す。__Started がログに出てから次へ進むのが肝。
こうしてアクション単位で、次のようなものが読めるようになります。
- 発行された SQL / DB の変化(ログレベルが
debug前提) - N+1:同じタグの中で同一の
SELECTが連発していれば N+1、IN (...)に集約されていれば正常 - enum の型不一致:
Parameters:行で実送信値が文字列か整数かを確認 - バリデーションメッセージ:空で保存したときに期待どおりのメッセージが出るか
- テナント境界:別テナントの id に差し替えて 200 が返ってしまわないか
なお、N+1 の検出「だけ」であれば Rails には Bullet のような専用 gem があり、普段使いならそれを入れるのが一番です。ここで言いたいのは、専用ツールを入れなくてもこの1つのログビューで N+1・発行 SQL・バリデーション・パラメータの型までまとめて見えること、そして後述の旧・新の実装比較のように「2つの実装が実際に流したクエリを突き合わせる」用途にも、同じ仕組みでそのまま使えることです。
実例:システム移行の parity 検証
この手法が一番輝くのが、冒頭で触れたシステム移行です。
旧実装と新実装を URL ベースで並行稼働させておき、同じ UI 操作を、旧実装・新実装のどちらに送るかだけ切り替えて2周する。やることは、先ほどの route コールバックに「新実装なら URL を書き換える」分岐と、タグに旧・新の区別(-old / -new)を足すことだけです。
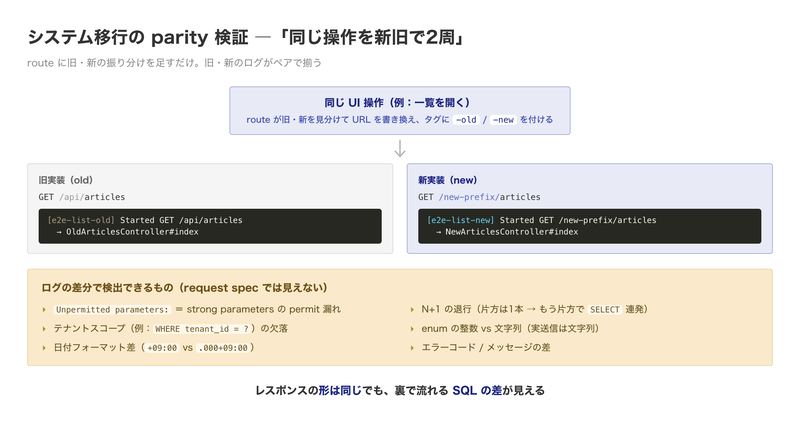
図4:同じ操作を旧・新で2周すると、旧・新のログがペアで揃う。レスポンスの形は同じでも、裏で流れる SQL の差が見える。
const url = target === 'new' ? origUrl.replace(re, '/new-prefix/$1') : origUrl;
const headers = { ...req.headers(), 'x-request-id': `${tag}-${target}` };
await route.continue({ url, headers });
すると、同じ操作から旧・新のペアがログに揃います。
[e2e-article-list-old] Started GET /api/articles       → OldArticlesController#index
[e2e-article-list-new] Started GET /new-prefix/articles → NewArticlesController#index
同じ操作なので、あとは -old と -new を突き合わせるだけ。これで、たとえばこういう差分がリリース前に機械的に検出できます。
- strong parameters の permit 漏れ(
Unpermitted parameters:が片方にだけ出る) - N+1 の退行(片方では1本だった SELECT がもう片方で連発)
- 絞り込み条件(
WHERE句)の欠落 - enum の整数 vs 文字列、日付フォーマット差、エラーコード/メッセージの差
いずれも、件数やステータスコードしか見ていない request spec では取り逃しがちなものです。「レスポンスの形は合っているのに、裏で流れる SQL が違う」を、ログの差分として機械的に判定できるのが効きました。
セキュリティの話:X-Request-Id を使って大丈夫なのか
外部の値をヘッダで受け取ってログに載せる、と聞くと身構える方もいると思います。結論から言うと、この手法自体はリスクになりません。理由は2つです。
X-Request-Idは受け身の観測ラベルにすぎない。認証・認可・ルーティング・テナント判定・業務ロジックのどの分岐にも使われていません。値を細工しても、何かをバイパスしたり権限を昇格したりする経路が存在しない。ただログを相関させるための札です。Rails が外部由来の値を自動でサニタイズする。先に出た
make_request_idがgsub(/[^\w\-@]/, "").first(255)で、英数字・アンダースコア・ハイフン・アットマーク以外を除去し 255 文字で切り詰めます。つまり、untrusted な入力をログに載せるときの典型的なリスクであるログインジェクション(改行を注入して偽のログ行を捏造する類)は、フレームワーク側で既に無効化されています。
しかも、この手法はサーバに一切手を入れず、Rails が元から読んでいるヘッダに乗るだけです。本番の攻撃面は増えません。
一般論として、本番ではクライアントが任意の request_id を送れる以上、「トレース ID をわざと衝突させてログ相関を濁す」程度の余地はあります。定石は、エッジ(LB や CDN)で request_id を上書き生成してクライアントの値を信用しない運用にすること。とはいえこれは本手法に固有の話ではなく、前述のサニタイズと 255 文字上限で最悪ケースは既に潰れています。
なお、検証自体はローカルの非本番環境で行うのが前提です。
まとめ
- request spec は in-process で型やエンコードを作者が固定してしまうため、実 HTTP でしか出ないバグ(型・CORS・環境差・シリアライズ)を取り逃します。実ブラウザ + 実サーバへ叩いて、ログで裏を取るのが効きます。
config.log_tags = [:request_id]とX-Request-Idを使えば、アクションとログを 1 対 1 で対応づけられ、grep '\[e2e-'の1本でノイズなくアクション単位の SQL やバリデーションを観測できます。- Claude Code の Monitor はこのログ観測と相性がよく、「操作 → ログ確認 → 次」のループを、実発火の裏取りまで含めて AI エージェントに任せられます。
- 導入コストはほぼゼロ。特別な計装は要らず、Rails が元々持っている仕組みに乗るだけです。
「テストは通るのに本番で壊れる」に心当たりがある方は、ぜひ一度、実ブラウザから叩いてログを覗いてみてください。思ったより多くのことが見えます。
